診断
AI 導入は過去最高、指標は昔のまま。テスターの時間はどこに消えているのか。
State of Testing 2026 · 70% 問題
AI 導入は過去最高、指標は昔のまま
第0章 · 診断State of Testing Report 2026(PractiTest と Tea-time with Testers による調査)

業界はツールを新しくしましたが、考え方は変わっていません。私たちはまだテスト工場の中にいて、合否で測られ、価値ではなく量で評価されています。
出典: State of Testing 2026。56% のチームはテストカバレッジで評価されています。
事務的な負担
- ドキュメントと成果物の管理
- 繰り返しの分析とレポート作成
- 自動テストの保守
- 進捗報告とテストレポート
- 失敗したテストからの情報収集
専門的な仕事
- 批判的思考とリスク判断
- テスト容易性の評価
- 深い探索
- コンテキストの分析
- 戦略的なテスト
70/30 の比率は、Lalit が複数のチームで観察した数字で、公表された統計ではありません。
Quality Conscious Software Delivery
QCSD の誕生、その中身、もたらした変化、そして人手で回すときのコスト。
誕生 · QCSD とは · 5つのフェーズ · 成果 · 厳密さのコスト
QCSD の誕生
第1章 · 必要から生まれた実在のデリバリーチーム、実在のプロダクト、そしてチームの出荷ペースより速く膨らみ続けるバックログ。

チームが抱えていた問題
QCSD とは
第2章 · Quality Conscious Software Delivery品質を意識する人々が、品質を高めるプロセスで、品質の高いプロダクトを届ける。
品質は、プロダクトだけの性質ではありません
- プロダクトは人がつくる
- 人はプロジェクトの中で、プロセスに沿って働く
- プロジェクト、人、プロダクトの品質は互いに影響し合う
Enable、Engage、Execute、Evaluate
すべてのビルド、機能、リリース、課題を、1つのビジネス上の問いで判断する
テスト自動化を 80% 増やす
機能テスター · API テスター · 自動化チーム · 運用
ビルド判定シナリオの自動化 · CI パイプラインの支援
シナリオ一覧 · 実行可能なスクリプト · スモークテストのパイプライン · CI ダッシュボード
5つのフェーズ
第3章 · フレームワークデリバリーのすべてのフェーズに品質の仕事を置き、それぞれに名前のついたセッションがあります。フェーズを選んでください。
成果
第4章 · 結果、評価、普及- リードタイムの短縮
- 明白なバグがない
- 本番バグはごくわずか
- 手戻りの減少
- スプリントあたりのリリース機能が増加
- スプリント内に取り込むチケットが増加
- 継続的な発見
- 継続的なフィードバック
- 継続的な品質
QCSD は 2022年に EuroSTAR Software Testing の最優秀論文賞を受賞しました。 論文を読む
iFM engineering が QCSD 導入の事例を独自に公開しました。
QCSD は Accenture の複数のクライアント案件で適用されています。
上流での厳密さのコスト
第5章 · すべてのチームができるわけではない理由最初から正しくつくるほうが常に安上がりなので、QCSD は機能します。最初から正しくつくるには、コードが1行もないうちに、熟練した人たちを同じ部屋に集める必要があります。1つの機能に必要なセッションを足していきます。
- シニアの時間を、機能ごとに繰り返し使う
- 締め切りが動くと、真っ先に削られる
- うまく回すには、部屋にコーチが必要
コスト、スピード、品質のトレードオフ
第5章 · すべてのチームができるわけではない理由コスト、スピード、品質: 選べるのは2つ
上流での厳密さは、コストかスピードと引き換えに、品質を引き上げてきました。
Agentic QCSD と Designed Agency
AI エージェントが担う上流の厳密さと、そこに設計して組み込む判断。
Agentic QCSD · セッションからスウォームへ · 70/30 の比率 · 症状への答え · Designed Agency
Agentic QCSD: AI エージェントで強化した QCSD
第6章 · AI エージェントが担う上流の厳密さ目的も、人も、プロセスも同じです。AI エージェントが、上流の厳密さを実現可能で、手頃で、より賢いものにします。
すべての QCSD セッションに AI エージェントのスウォームがつき、すべてのスプリントのすべてのストーリーで下準備を行います。判断するのは人です。
コーチや空いている午後を待たずに、すべてのエピックとすべてのストーリーで厳密さが回ります。
AI エージェントが収集、分析、下書きをし、人は判断が必要なゲートにだけ時間を使います。
1つの共有ナレッジグラフが、すべてのスウォーム、すべてのチーム、すべての本番障害から学びます。

知識労働者はそれぞれ、真実の一部を持っている
- PO、アーキテクト、開発者、テスターは、それぞれ真実の別の部分を知っている
- Agentic QCSD は、それらの部分を、すべてのスウォームが読む1つの共有メモリに集める
- どの判断も、集めた真実をテーブルに載せて行う
QCSD セッションから Agentic QE スウォームへ
第6章 · Agentic QCSDセッションは残ります。AI エージェントのスウォームがすべてのストーリーの準備を行い、判断するのは人です。
Agentic QCSD は 70/30 の比率をどう変えるか
第6章 · Agentic QCSD事務的な 70% は AI エージェントへ移ります。専門的な 30% が、すべてのゲートでのテスターの仕事になります。
- ドキュメントと成果物→ストーリーごとにフェーズレポートを下書き
- 繰り返しの分析→すべてのストーリーで SFDIPOT とリスクスコアリング
- 自動テストの保守→テストアイデアからテストを生成
- 進捗報告とレポート→根拠つきの GO、CONDITIONAL、NO-GO の判定
- 失敗したテストからの知見→根本原因分析と欠陥予測
- リスク判断どのリスクがストーリーを止めるかを決める
- 批判的思考判定とその根拠を疑う
- テスト容易性テストできるようにするための変更を求める
- 深い探索AI エージェントが見なかった場所を探索する
- コンテキストビジネスとドメインの知識を持ち込む
症状と、それに答える手法
第7章 · 設計による解決症状を選んでください。
Agentic QCSD は Designed Agency の上に築かれています
第8章 · Designed Agency業界は agentic という言葉を、その意味を吟味するより早く取り入れました。Designed Agency は、私たちの文脈でそれが何を意味するのかを考え、定義することを求めます。
- LLM が次の一手を決める
- ツールを呼び出す
- ループで動く
- アーキテクチャのない判断のエンコードは、ただのプロンプト
- 判断をエンコードしていないアーキテクチャは、ただの配管
- 誠実な近似がなければ、つくったものが良いかどうかを知る方法はない
仕事を深く理解した実践者が、意図して設計に組み込む判断。判断をエンコードし、アーキテクチャに落とし込み、誠実に測定できる人たちによって。
- Encoded糸。布をつくる素材
- Structured(構造化)織機。素材に働きかける道具
- Approximated糸と糸の接点。布に風合いを与えるもの
Designed Agency の3つの次元
第8章 · Designed Agency3つの次元と、それが AI エージェントにどう現れるか。次元を選んでください。
参考文献: Congratulations on your agent. Does it have agency? · Lalitkumar Bhamare(LinkedIn)
70% 問題
Agentic QCSD でテストの知的な核を取り戻す
 Lalitkumar BhamareDragan Spiridonov
はじめる前に
講師の紹介、進行表、作業環境、そしてウォームアップ演習。
講師 · 進行表 · セットアップ · 演習 0
本日の講師
講師Lalitkumar Bhamare
EMEA リード、品質エンジニアリング ソートリーダーシップ · Accenture Song
- QCSD(Quality Conscious Software Delivery)の考案者。EuroSTAR 2022 最優秀論文賞。
- Agentic QCSD の考案者。オープンソースの Agentic QE フレームワークの主要な貢献者。
- Tea-time with Testers 共同創設者・編集長。元 AST 教育担当 VP。
- State of Testing 2026 共著者。Emerging QA Leader of the Year 2025。
Dragan Spiridonov
Head of Agentic Quality Engineering · Cognitum One · 本日はビデオで参加
- Agentic QE フレームワークの考案者。PACT を PACTS に発展させた。
- テクノロジー分野で 29年。そのうち 12年は企業で品質エンジニアリング組織を立ち上げてきた。
- Agentic QE Fleet の考案者。Serbian Agentic Foundation Chapter 創設メンバー。
- 元 Belgrade Test Conference プログラム委員長。forge-quality.dev で執筆。
進行表
13:00–16:00ワークショップの作業環境をセットアップする
13:00–13:10Codespaces は GitHub 上で動きます。DevPod は Docker を使ってローカルで動きます。AI エージェントの演習には、ご自身のモデルアクセスとトークンを使います。 ワークショップのリポジトリ: bit.ly/ttf-agentic-qcsd
devpod up . --provider dockerまたはリポジトリを Codespace で開くbash .devcontainer/prepare-workshop.shbash .devcontainer/verify.sh続けてnpm run test:run- コンテナ内で AI エージェントにサインインします。ワークスペースを信頼し、AQE MCP サーバーを承認します。
- LAB.md を開きます。演習 0 は準備済みです。出力を確認してください。
git clone https://github.com/fndlalit/TTF-Agentic-QCSD-Workshop-JAnpm install -g agentic-qe@latestaqe init --autonpm installaqe code index src/npm install -g @huggingface/transformers@4.2.0aqe learning import -i seed/aqe-seed-patterns.json
Node 22.13 以上、npm 10 以上。
ホームフォルダの近くにクローンしてください。階層が深いと、グラフからファイルが抜け落ちます。
次を追加: --with-copilot, --with-cursor または --with-kiro.
詳しい手順: チュートリアルのリポジトリにある docs/DEVCONTAINER.md と README.md。
ウォームアップ: フリートにコードの地図を渡す
演習 0 · 13:10–13:20約2分 · AI エージェント経由ではなくターミナルで · API キー不要、トークン消費なし
aqe code index src/
21 ファイル · 102 ノード · 117 エッジ
aqe hg stats
手動セットアップ: 140 ノード · 102 エッジ。
コンテナ: 110 ノード · 89 エッジ。
aqe memory usage
開始前は 21 エントリ · 81 ベクトル
作業環境の中での静的解析とローカル埋め込みです。プロバイダーのキーもトークンも不要です。コンテナでは、prepare-workshop.sh がこの3つのコマンドを実行済みです。
エンジン
スウォームのアーキテクチャ、フィードバックループ、そして考案者による Agentic QE フレームワークの紹介。
アーキテクチャ · エンジン · Dragan による AQE 紹介
スウォームのアーキテクチャとフィードバックループ
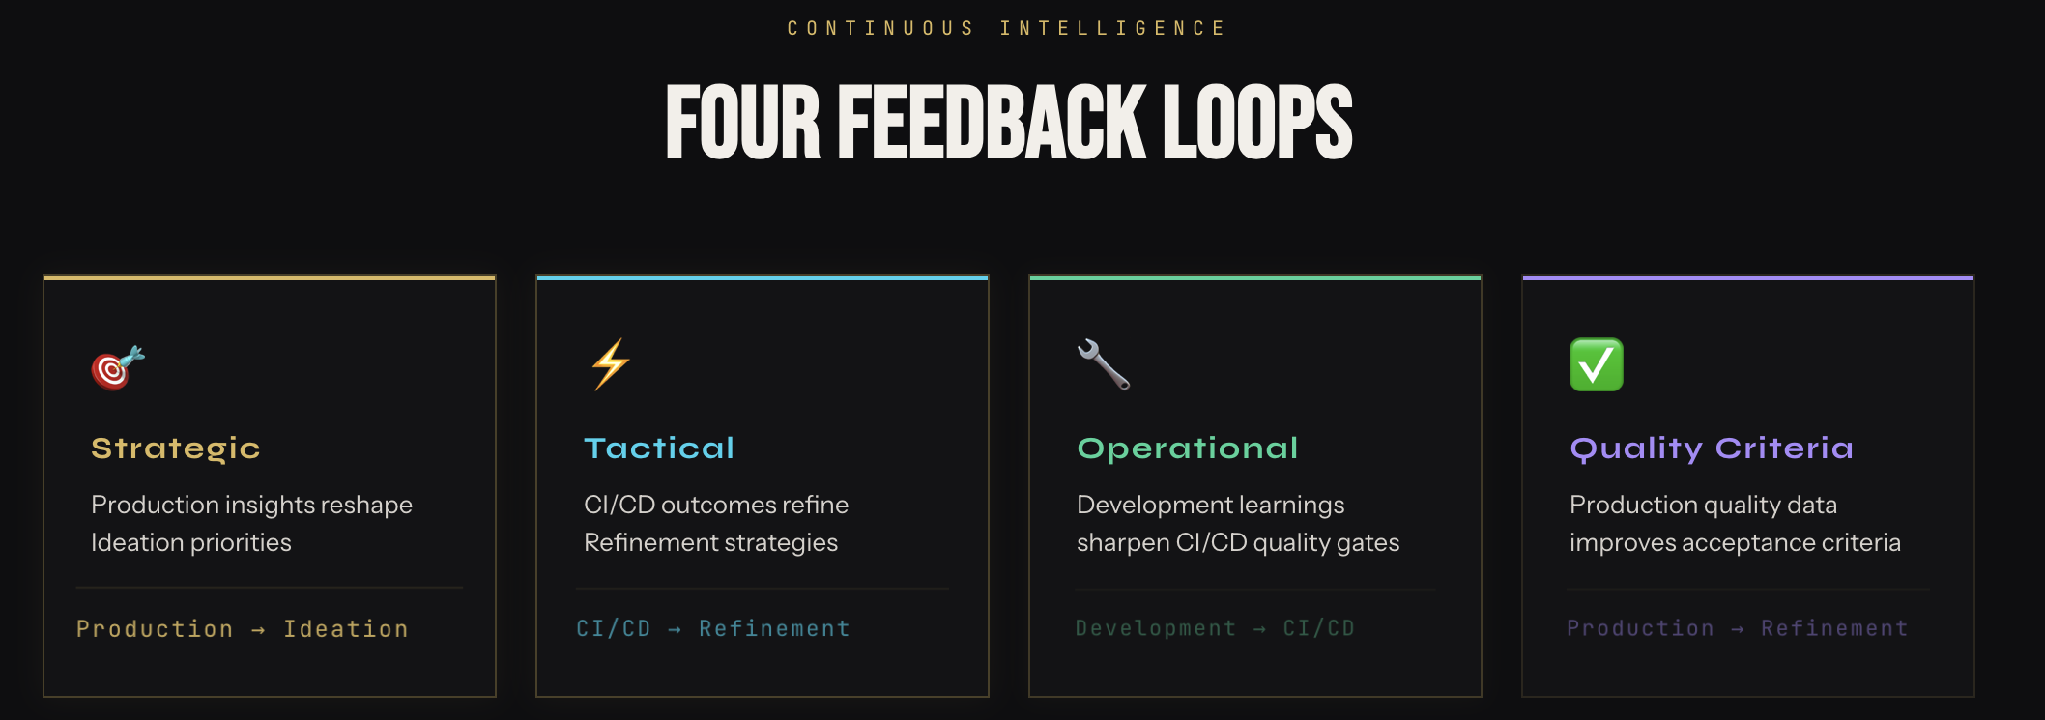
アーキテクチャ · 13:35–13:40フェーズごとに1つ、計5つのスウォームが、それぞれの発見を次へ渡します。4つのフィードバックループが、各フェーズで学んだことを、それを活かせるフェーズへ戻します。
すべてを動かすエンジン
アーキテクチャ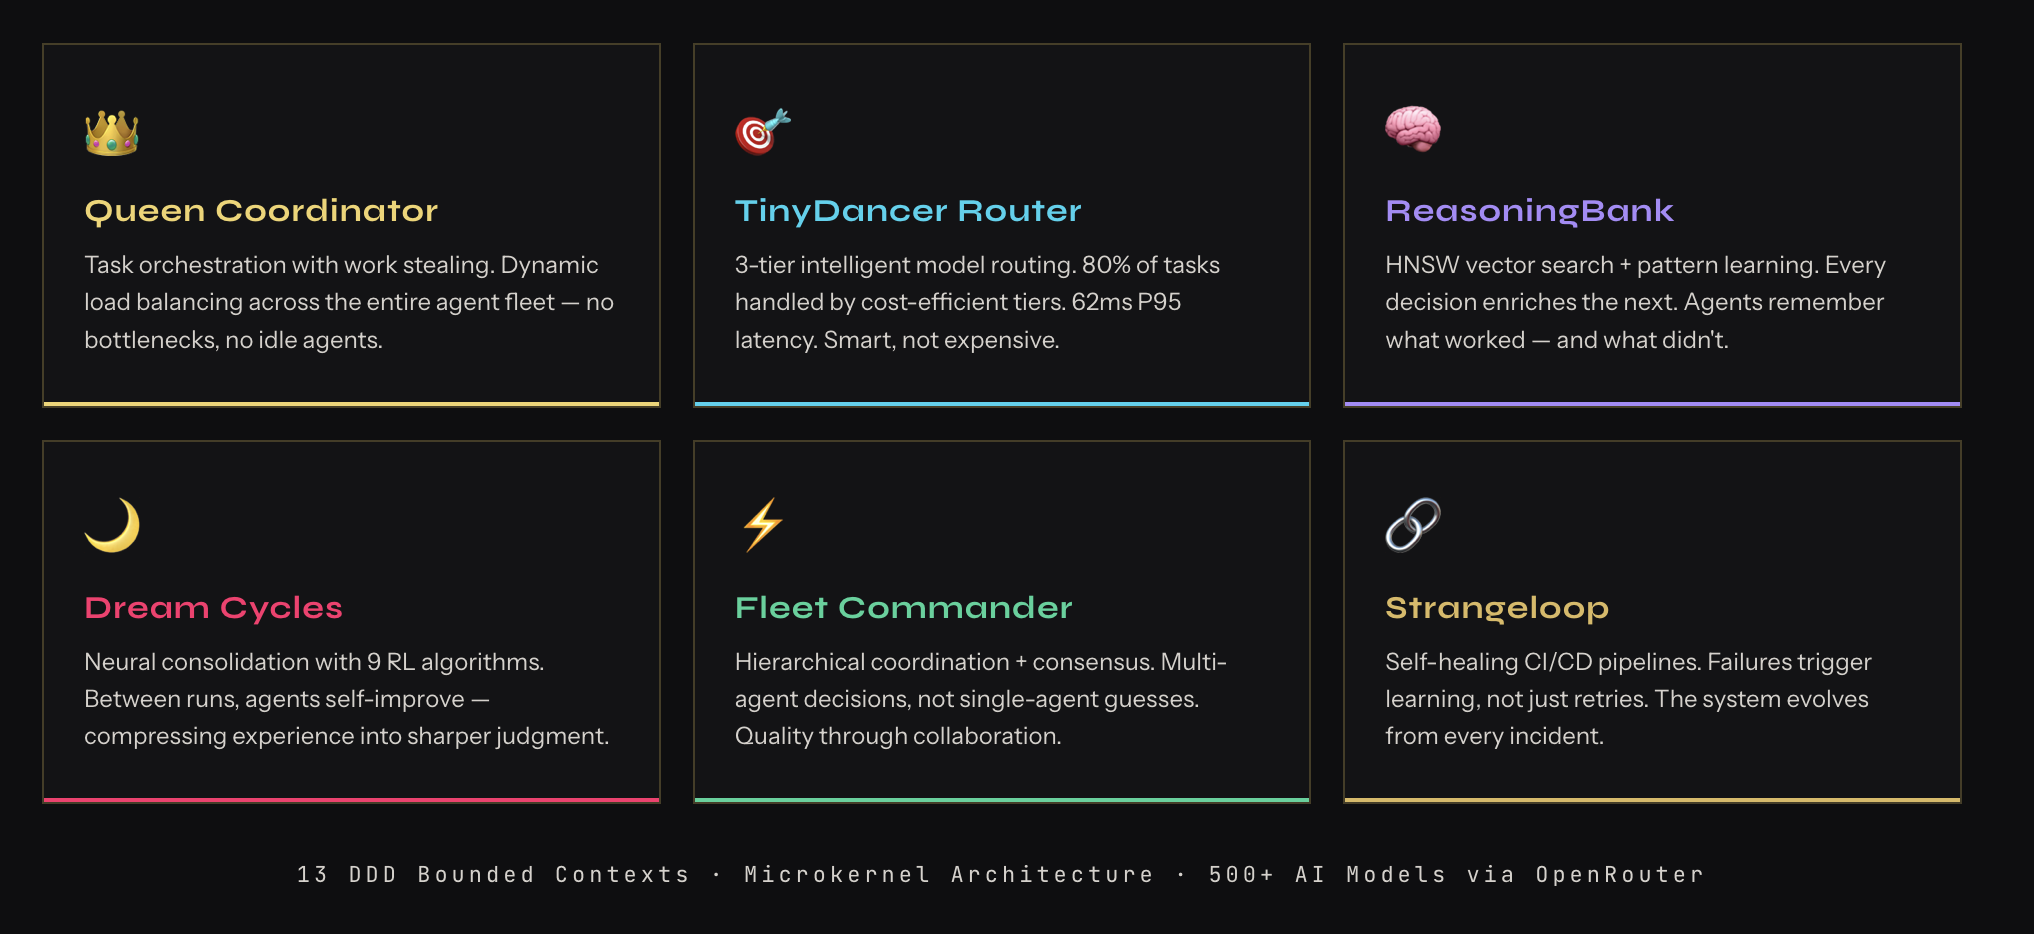
考案者による Agentic QE フレームワーク
AQE 紹介 · Dragan Spiridonov · ビデオ · 14分Dragan Spiridonov · Head of Agentic Quality Engineering, Cognitum One · Agentic QE フレームワークの考案者 · github.com/proffesor-for-testing/agentic-qeハンズオンラボ
1つのチェックアウトアプリで5つの演習。エピックからリリース判断まで。
アイデア出し · リファインメント · 開発 · CI/CD · 自己学習
 アイデア出し: コードを書く前にリスクを洗い出す
演習 1 · アイデア出し · 13:55–14:20約20分 · qcsd-ideation-swarm · コマンドファイルではなくスキルとしてインストール済み
/qcsd-ideation-swarm

Analyze the guest-checkout epic in requirements/epic-checkout.md, using requirements/user-stories.md and requirements/acceptance-criteria.md for context. Work from these files only, with no web research. Skip the security audit: Exercise 4 covers security.
Save all reports under reports/01-ideation-swarm/.
Save learnings and persist patterns.
reports/01-ideation-swarm/LAB.md に2つのバージョンエピックをご自身で読んでください。あなたなら GO、CONDITIONAL、NO-GO のどれを出しますか。
この作業環境で AI エージェントにサインインし、AQE MCP サーバーを承認しておきます。Claude Code 以外の方は、LAB.md のステップ一覧を使ってください。
演習 1 の振り返り
各枠の最後の5分 · ペアで、その後全員でアイデア出し: コードを書く前にリスクを洗い出す
どの判定が出ましたか。
NO-GO、CONDITIONAL、GO のどれか。エグゼクティブサマリーで判定と主なブロッカーを探してください。
エピック、ストーリー、基準の間のどの矛盾を見つけましたか。
1つを requirements/ のファイルと照らし合わせてください。本当に矛盾していますか。
何がなければ開発を始めるのを断りますか。
判定を挙手で確認し、テーブルごとにブロッカーを1つ。
開く reports/01-ideation-swarm/
私たちの実測結果(振り返りの後に開く)
2026年11月6日に実測(agentic-qe 3.15.18、Claude Code、無人実行): 6.7分、$2.25。対話的に実行すると、ツール呼び出しの承認がある分だけ長くなります。この実行での判定: CONDITIONAL、リスク 39件(重大 4件)、テスト容易性 59%、要件の網羅性 46%。スキルのより厳しいしきい値表では NO-GO となり、レポートにもそう書かれています。
コーヒーブレイク
14:35 に再開します。演習 1 のレポートは開いたままにしてください。
次 · 演習 2 · リファインメント: カバレッジの前にプロダクト要素
 リファインメント: カバレッジの前にプロダクト要素
演習 2 · リファインメント · 14:35–14:50約10分 · qe-product-factors-assessor
Use qe-product-factors-assessor to analyse the guest-checkout product from requirements/epic-checkout.md and requirements/user-stories.md. Produce a product-factors (SFDIPOT) assessment and save it to reports/02-refinement-product-factors.md.
Save learnings and persist patterns.
reports/02-refinement-product-factors.mdLAB.md に2つのバージョン7つの要素のうち、ここで最もリスクが高いのはどれだと思いますか。
構造、機能、データ、インターフェース、プラットフォーム、運用、時間。
演習 2 の振り返り
各枠の最後の5分 · ペアで、その後全員でリファインメント: カバレッジの前にプロダクト要素
7つの要素のうち、テストアイデアが最も多かったのはどれで、最も少なかったのはどれですか。
構造、機能、データ、インターフェース、プラットフォーム、運用、時間。
自分では思いつかなかったテストアイデアはどれですか。
次に、どのチェックアウトにも当てはまるほど汎用的なものを1つ探してください。
このビジネスにとって本当のリスクはどの要素にありますか。
テーブルごとに要素を1つ、理由とともに。
開く reports/02-refinement-product-factors.md
私たちの実測結果(振り返りの後に開く)
2026年11月6日に実測(agentic-qe 3.15.18、Claude Code、無人実行): 3.3分、$0.52。AI エージェントは SFDIPOT の7要素にわたり 74件のテストアイデア、23件の要件の抜け、順位づけした 11件のリスクを出しました。受け入れ基準のファイルは読んでいません。会場で問いかける価値があります。
 開発: 最もリスクの高いモジュールのテスト
演習 3 · 開発 · 14:50–15:10約15分 · qe-test-architect
Use qe-test-architect to generate a comprehensive test file for the payment-retry logic in src/lib/payment-retry.ts. Use the test ideas in reports/02-refinement-product-factors.md as input, and include property-based tests for the module's invariants.
Save the test file as tests/lib/payment-retry.architect.test.ts and a short rationale to reports/03-development-tests.md.
Save learnings and persist patterns.
tests/lib/payment-retry.architect.test.tsLAB.md に2つのバージョンsrc/lib/payment-retry.ts を開いてください。テストが守るべき不変条件を1つ挙げてください。
このステップは演習 2 の出力を読みます。順番どおりに実行してください。
演習 3 の振り返り
各枠の最後の5分 · ペアで、その後全員で開発: 最もリスクの高いモジュールのテスト
生成されたテストは実行でき、合格しますか。
失敗したテストについて、間違っているのはテストかコードかを判断してください。
プロパティベーステストはどの不変条件を選びましたか。
バックオフの上限、リトライ回数の上限、冪等性を探してください。
それは本当に重要な不変条件ですか。
テーブルごとに、欠けている不変条件を1つ。
実行 npm test -- --run tests/lib/payment-retry.architect.test.ts
私たちの実測結果(振り返りの後に開く)
2026年11月6日に実測(agentic-qe 3.15.18、Claude Code、無人実行): 3.0分、$0.55。AI エージェントは fast-check のプロパティテストを含む 74件のテストを書き、すべて合格しました。it.fails のテスト1件は、遅延の上限を適用した後にジッターが加算されることを記録しています。card_declined コードも含め、投げられたエラーはすべてリトライされることも記録しました。
 CI/CD: 検証し、ゲートを通し、判断する
演習 4 · CI/CD · 15:10–15:25約10分 · qe-queen-coordinator
Use qe-queen-coordinator to run a verification-only quality assessment of src/lib/payment-retry.ts (do NOT generate tests). Analyse coverage gaps with risk scoring, security-scan the module, apply a 90% quality gate, and give a GO / CONDITIONAL / NO-GO deployment recommendation with the top blockers.
Save the consolidated report to reports/04-cicd-quality-assessment.md.
Save learnings and persist patterns.
reports/04-cicd-quality-assessment.mdLAB.md に2つのバージョンsrc/lib/payment-retry.ts を読んでください。リリースしますか。答えを書き留めてください。
演習 3 でテストを追加する前の payment-retry.ts は、ステートメント 100%、ブランチ 97.29% です。追加後は 109件中 109件が合格し、カバレッジは 100% です。カバレッジだけではリリース判断はできません。
演習 4 の振り返り
各枠の最後の5分 · ペアで、その後全員でCI/CD: 検証し、ゲートを通し、判断する
どの推奨が出ましたか。
NO-GO、CONDITIONAL、GO のどれか。ゲートのスコアとカバレッジの数値を比べてください。
冪等性キーがないこと、ジッターの前にバックオフの上限が適用されていることを報告しましたか。
どちらもモジュールのソースにあります。
リリースしますか。
挙手で確認し、何がなくてもリリースしてよいかを話し合います。
開く reports/04-cicd-quality-assessment.md
私たちの実測結果(振り返りの後に開く)
2026年11月6日に実測(agentic-qe 3.15.18、Claude Code、無人実行): 1.4分、$0.34。この実行での判定: 109件中 109件のテストが合格、カバレッジ 100% で NO-GO。ブロッカー: 冪等性キーがない、ゲートウェイのタイムアウトがない、投げられたエラーをすべてリトライする。quality_assess のゲート呼び出しは「証拠不十分」を返したため、AI エージェントが 90% のしきい値を自分で適用しました。
 自己学習: フリートの記憶を活用する
演習 5 · 自己学習 · 15:25–15:35約10分 · どのツールでも同じプロンプト
Recall from AQE memory what the fleet learned about this checkout app across Exercises 1–4: payment retry, cart state, checkout form accessibility, and request validation.

First list what you recalled: each pattern's name and one line on what it says. Then consolidate that into a one-page brief (top risks, testability gaps, contradictions, and the release verdict), framed as either:
  • an onboarding brief for someone joining the project today, or
  • a handoff document for the next person enhancing the checkout app.

Where memory returns nothing for a topic, take it from reports/01 to 04 and label that part REPORTS-BASED.

Save the brief to reports/05-handoff-brief.md.
reports/05-handoff-brief.mdどのツールでも同じプロンプト演習 1〜4 で覚えているリスクを3つ書き出し、想起結果と照らし合わせてください。
- 演習全体で順位づけした主なリスク
- 品質の仕事を妨げるテスト容易性の欠落
- エピック、ストーリー、基準の間の矛盾
- リリース判定とそのブロッカー
演習 5 の振り返り
各枠の最後の5分 · ペアで、その後全員で自己学習: フリートの記憶を活用する
想起したリストにこのコードベースの名前は出てきますか。
payment-retry.ts、CartContext、CheckoutForm.tsx がすべて出てくるはずです。
ブリーフのどの部分が REPORTS-BASED ですか。
それらのトピックはメモリにありませんでした。ご自身のレポートと比べてください。
このブリーフを、このコードの次の担当者に渡せますか。
テーブルごとに、最初に追加したいものを1つ。
開く reports/05-handoff-brief.md
私たちの実測結果(振り返りの後に開く)
2026年11月6日に実測(agentic-qe 3.15.18、Claude Code、無人実行): 1.0分、$0.29。メモリは learning 名前空間から4つのパターンを返し、どのトピックでも同じ4つでした。カートの状態、フォームのアクセシビリティ、リクエストの検証はレポートから取られました。一部をレポートから組み立てたブリーフも正しい結果ですが、そのことを明記する必要があります。
発展演習 2b · プロダクト要素からの探索的チャーター
発展演習 · セッション後に約20分 · exploratory-testing-advanced
/exploratory-testing-advanced

Using the test ideas in reports/02-refinement-product-factors.md, write three time-boxed exploratory charters for the guest checkout and run a first pass of each against src/app/checkout, src/components/CheckoutForm.tsx and src/lib/. Label every finding EXECUTED, STATIC or INFERRED; list the questions a human must answer.
Save to reports/02b-exploratory-charters.md.
Save learnings and persist patterns.
reports/02b-exploratory-charters.md最初に実行するチャーターはどれか。どの発見が推測ではなく証拠か。
発展演習 2c · 欠陥リスクプロファイル: バグはどこにあるか
発展演習 · セッション後に約15分 · qe-defect-predictor
Use qe-defect-predictor to build a defect risk profile for every module in src/lib/ and src/components/CheckoutForm.tsx from complexity, coupling and coverage (npm run test:coverage). Rank the modules, give the top three risk factors for each with its evidence class, and say whether src/lib/payment-retry.ts belongs at the top of the list, and why.
Save to reports/02c-defect-risk-profile.md.
Save learnings and persist patterns.
reports/02c-defect-risk-profile.mdpayment-retry.ts のカバレッジはすでに 100% です。それでも上位に来るなら、その理由に同意できるかを判断してください。
実践へ
スウォームが準備するもの、PACTS による問いかけ方、そしてあなたの現場のためのロードマップ。
まとめ · PACTS · ロードマップ · 持ち帰るもの
スウォームが準備するもの、あなたが決めること
まとめPACTS: 5つの問いかけの道具
PACTS の適用 · 15:35各特性は定義ではなく問いです。ご自身のレポートに当てはめ、ペアで各特性を 0〜3 で採点し、答えが薄いときは深掘りの問いを使ってください。
Proactive(先回り)
聞かれる前にリスクを指摘したか。
「結論の根拠になった src/ の行を正確に示して」Autonomous(自律)
何を調べるかを自分で決めたか。
「見なかったもので最も重要なものは何?」Collaborative(協働)
AI エージェント同士が互いを参照したか。
「AI エージェント A と B は上位3つのリスクで一致している?」Targeted(的確)
このチェックアウトのコードに合っていたか。
「汎用のチェックリストではなく、私たちの文脈に合わせて書き直して」Structured(構造化)
それぞれの結論を根拠までたどれるか。
「経緯を見せて: どの AI エージェントが、どの入力から、なぜこう判断した?」あなたの現場での出発点
ロードマップ · 15:45–15:55npm install -g agentic-qe@latestaqe init --autoご自身のプロジェクトで- スキルライブラリを眺める
- 最も大きな事務的負担を選ぶ
- qe-qx-partner、qe-flaky-hunter、qe-accessibility-auditor を試す
- 最初の1週間で削減した時間を測る
- 信頼が育つにつれて AI エージェントを追加する
- 1か月目: AI エージェントが提案し、人が決める
- 4か月目: 低リスクの仕事は AI エージェントが担う
持ち帰るもの
まとめ- 長年の投資なしで使える、専門家の思考。
- ご自身のマシンにある、設定済みで MIT ライセンスのフレームワーク。出し惜しみはありません。
- どこでも使え、ベンダーに依存しない評価の感覚としての PACTS。
- 私たちではなく、あなたの現場のために書いた導入ロードマップ。
- bit.ly/ttf-agentic-qcsd
- github.com/fndlalit/TTF-Agentic-QCSD-Workshop-JA
- github.com/proffesor-for-testing/agentic-qe
- agentic-qe.dev
- forge-quality.dev
- teatimewithtesters.com
QCSD 論文: EuroSTAR Huddle · Designed Agency: LinkedIn の記事
Lalitkumar BhamareDragan Spiridonov速い馬では救われない。
考えるチームを増幅すれば、救われる。
bit.ly/ttf-agentic-qcsd · teatimewithtesters.com · forge-quality.dev · agentic-qe.dev